400-040-9002

AI客服“胡说八道”怎么治?RAG召回、置信度阈值与兜底话术
AI客服最贵的错误不是答不上来,而是答得很像那么回事,但答案是错的。
答不上来,客户会追问、会转人工,损失一次交互;答错了,客户会照着错误信息去办事——跑错网点、带错材料、错过期限,损失的是信任,还要企业来兜底。
“幻觉”这个词被用得太泛,导致很多团队一上来就想换模型。但实际项目里,大部分错误答案不是模型笨,而是检索没给到对的材料,或者系统不知道该说“我不知道”。这篇按工程链路拆,从病根到药方。
一、先分清三种“胡说”,病根完全不同
第一种:知识缺失型。知识库里根本没有这条业务规则,模型只能用通用常识补。比如客户问“我们这个城市的退费要几个工作日”,知识库只写了“按流程办理”,模型就会自己编一个“3到5个工作日”。
这类错误的特征是:答案通顺、合理、但没有出处。药方是补知识、而不是调模型。
第二种:召回错误型。知识库里有正确材料,但检索没召回来,或者召回的是另一条相似但条件不同的规则。比如“新客首单立减”和“复购满减”两条政策,语义接近,检索把复购那条给了新客场景。
这类错误的特征是:答案有依据,但依据错了。药方在检索链路,不在生成端。
第三种:生成过度型。材料给对了,模型却做了超出材料的推断、合并、承诺。比如材料写“可申请延期”,模型答成“一定可以延期,不会影响征信”。
这类错误的特征是:答案沾边,但越界了。药方在提示词约束、输出校验和兜底策略。
不分清这三类,就会陷入“不停换模型、问题依旧”的循环。
二、RAG链路上的五个高频失效点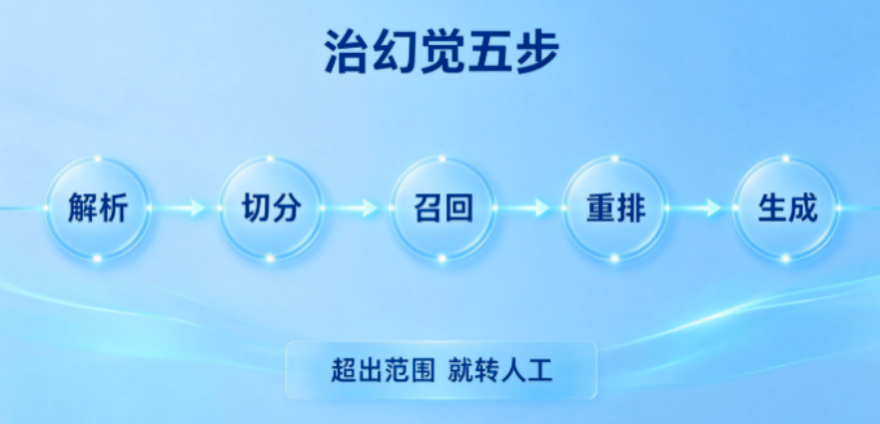
RAG不是“把文档丢进去就能答”,它是一条链,每一环都可能漏。
第一环:文档解析。PDF两栏排版被读成一行、表格被读成流水文字、扫描件没做OCR、附件图片里的规则没被提取——这些在解析阶段就丢了。后面检索再准,也是在残缺的材料里找。
第二环:切分粒度。切得太碎,一条规则被拆成三段,每段都不完整;切得太粗,一个chunk里混了三个主题,向量被平均掉,检索时反而不命中。业务规则类文档建议按条款/问答对切分,而不是按固定字数机械切。
第三环:召回方式单一。纯向量检索擅长语义相近,但对编号、产品名、专有名词、缩写不敏感。客户问“B23套餐”,向量可能召回一堆“套餐”相关内容,却漏掉真正那条。工程上通常要做混合检索:向量召回+关键词/BM25召回,再合并去重。
第四环:没有重排。召回Top20直接丢给模型,噪声比例很高。加一层rerank(重排)把真正相关的排到前面,是性价比最高的一步优化——成本远低于换模型。
第五环:上下文拼装。把召回的十条材料不加区分地拼进prompt,模型会串用不同条款的条件。正确做法是:带来源、带生效条件、带适用范围拼装,并明确告诉模型“只能依据以下材料回答”。
这五环里,前四环决定“材料对不对”,第五环决定“模型会不会用错”。
三、置信度阈值:不能只看一个相似度分数
很多系统判断“能不能答”,只看检索相似度分数,超过0.8就答。这个做法在真实业务里很不稳。
更可用的判断应该由多个信号合成:
几个信号同时偏低,就应该进入“不确定”分支,而不是硬答。实操上不必追求复杂模型,先用规则组合把明显不该答的场景拦下来,效果比调参更直接。
关键认知是:允许系统说“我不确定”,是降低错误率最有效的手段之一。很多项目错答率高,不是因为答不准,而是因为系统被要求“必须答”。
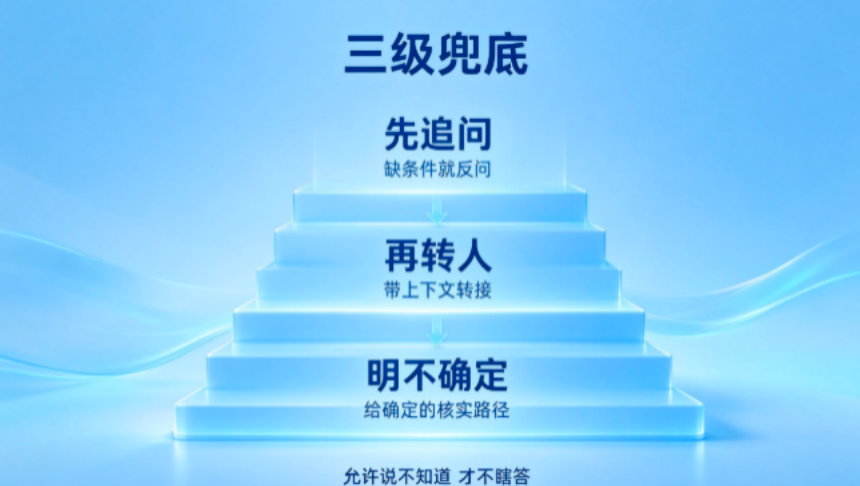
三、兜底话术:三级降级,而不是一句“抱歉没听懂”
兜底不是一句万能话术,而是一条降级路径。
第一级:澄清追问。当问题缺条件(没说城市、没说订单号),不要猜,反问补齐。“您是在哪个城市办理”比编一个答案安全得多。
第二级:知识外转人工。当召回为空或分数过低,直接给转人工入口,并把已收集的信息带过去,避免客户重复描述。这里体验差距很大:带上下文转接和从零转接,客户感受完全不同。
第三级:明确不确定+给确定路径。当业务必须给答复但不能瞎猜时,给“目前无法确认,建议您通过XX渠道核实”的明确表述,而不是模糊承诺。
三级兜底要写进知识库和对话流程配置里,而不是塞在提示词里靠模型自觉。
五、评测与运营:没有badcase集,就没有治理
RAG治理不是一次性调优,是持续运营。
建议上线前就建三样东西:
一是badcase集。把历史错答、客户投诉、人工纠正的对话整理成测试集,每次知识库更新、模型调整、切分策略变更,都跑一遍回归。没有回归集,优化就是盲改。
二是按类型归因。每条错答标注属于“知识缺失/召回错误/生成过度”哪一类,按月看分布。分布变化会告诉你下一步该补知识、改检索还是收紧生成。
三是线上监控。盯四个指标:转人工率、重复提问率、答案被追问率、差评关键词命中率。这四个指标异常,通常比准确率下降更早暴露问题。
六、华云天下在这条链上的解法
华云天下的企业知识中台(智库)和客效(全渠道智能客服)把这条链拆开做工程化:
解析层支持多格式文档解析与结构化抽取,表格、条款、附件内容按结构入库,而不是拍平成一段文字;检索层做向量+关键词混合召回,并加重排,业务编号、产品名这类强匹配需求不会漏;生成层限定在授权知识范围内作答,超出范围走降级路径;运营层提供知识命中率、未命中问题、转人工原因的日常报表,badcase可以反哺知识库。
部署上支持SaaS、专属云、全栈信创私有化,模型可以本地部署,对话数据不出企业边界——这对金融、政务、医疗是硬要求。信创侧适配飞腾、鲲鹏、龙芯、海光、兆芯与麒麟、统信、欧拉、达梦、人大金仓。
更实际的一点是:知识库不是交付即完成。华云天下的运营陪跑里包含知识库代搭建、话术代调优和定期的知识健康度复盘,解决的是“上线三个月后知识过期”这个最常见的失效场景。
七、给团队的一份落地清单
如果现在错答率高,按这个顺序排查,比换模型有效:
1.先看解析:抽20份核心文档,检查表格、条款、附件有没有被正确提取。
2.再看切分:随机取20个chunk,看是否一条chunk一个完整意思。
3.加混合检索:向量之外补关键词召回,专有名词类问题会立刻改善。
4.加重排:Top20重排到Top5,噪声下降明显。
5.改阈值逻辑:从单分数改为多信号组合,把“不该答”的场景拦住。
6.配三级兜底:澄清、转人工、明确不确定,三条路径都要有。
7.建badcase集:从今天开始积累,一个月后你会有明显感觉。
AI客服的准确率,从来不是模型榜单上的分数决定的,而是知识、检索、阈值、兜底、运营这五件事一起决定的。模型只负责最后一句话,前面四件事才是企业自己能控的部分。


公众号
视频号
热门标签: 企业知识中台解决方案 汽车行业解决方案 保险行业解决方案 银行行业解决方案 12345解决方案 数字化营销解决方案 消费品制造行业解决方案
友情链接: 数字人 企业AI门户 全媒体呼叫中心 AI中台 飞音传呼 AI前台宝 全媒体智能客服 在线客服 智能坐席助手 工单系统